本文结果来自自建的简化模拟,非 Design Arena 官方评测;VLM 偏好不代表真实用户投票,分数仅在各自比较中解释。
这个问题最初来自我们对 Visual Code Generation 评测的观察。近年来,大语言模型在代码生成领域取得了突破性进展,尤其是视觉代码生成(Visual Code Generation)展现出了巨大的潜力。以 GPT-5.6 Sol、Claude Fable 5 和 Kimi K3 为代表的最新一代模型,已经能够通过直接生成 HTML、SVG 和 CSS,自动化构建功能完整的网页、动态用户界面(UI)以及交互式的数据可视化图表。这种基于代码的生成方式,为自动化设计与前端开发带来了极大的想象空间。
两两偏好比较是讨论 Visual Code Generation 观感的一种方式,例如 Design Arena 采用的两两偏好比较:同一个 prompt 生成两个结果,再由用户选出更喜欢的一个。实际选择时,用户通常会倾向于那个看起来更好看、更完整的结果。
但“更好看”究竟是由什么决定的?
本文沿着一条具体线索展开:先把视觉需求写进设计规划,观察它如何改变素材使用与页面构建;再探索通过数据筛选与蒸馏,让这些行为在普通请求下也能出现。最后,我们把图像生成用作设计前的视觉参考,并保留代码产物的可编辑结构。
视觉丰富度,可能比我们想象中更重要
我们先不做论述,我们先来看看下方的结果,你会选择左右两边哪一个结果?
在这些选取的案例中,我们更偏好左侧的视觉效果。它们用于展示同一 prompt、同一模型下素材使用方式的差异,属于定性示例,不能据此推断所有任务或用户的偏好。
仔细看左右两边的产物,会发现它们在结构、布局、文字和数据上并没有非常大的差异。真正拉开观感的,是右边更多使用简单的几何色块、渐变或 emoji 占位,看起来仍然像一个半成品;而左边因为有更丰富的视觉素材,主视觉、质感和氛围都完整了起来。
模型知道怎么写代码,却很难跨过从“结构正确”到“视觉美观”的那道鸿沟。
所以,观感的决定权有很大一部分落在那些代码画不出来的地方。这些案例提示我们:素材获取方式可能影响生成结果的观感,值得进一步研究。
我们通常会把“AI 写出来的页面不好看”归因于模型缺乏审美,但一个更直接的解释是:HTML、SVG 和 CSS 很擅长结构控制与排版,却不擅长直接手写复杂的视觉素材。电影感背景、3D 主视觉、自然纹理、复杂插画——如果要求模型只用代码把这些画出来,不仅成本很高,也无法逾越能力的鸿沟。
Generation fills the asset gap of visual code
接下来,我们分别讨论允许调用工具的 Agentic 设置,以及单轮生成代码的 Non-Agentic 设置。以下比较是我们自己的简化模拟,先从 Agentic 设置开始。
缺的是素材,那就把素材给它
我们当然可以通过 Web 搜索等方式获取素材,但今天想更多讨论另一条路径:使用多模态生成工具,直接补上 Visual Code 中缺失的那部分视觉内容。我们为 Web-Dev、Poster 生成等任务挂载了以图像生成模型为核心的素材生成专用工具,并鼓励 Agent 更主动地调用它。Agent 会自主判断并按需调用图像、3D、视频等生成模型,产出代码难以手绘的局部视觉资产。
我们希望探索:视觉丰富度是否会影响生成页面的第一印象。为此,我们选取了一组网页生成任务,用 VLM 模拟普通用户进行两两偏好比较。这个代理指标可能受评审模型和提示词影响,不能等同于人类用户的判断。模拟使用的提示词如下:
Act as an ordinary user seeing two anonymous web designs. Based on your first
impression, choose the result you prefer based on which looks better, feels
clearer, and is more appealing to use. Choose A or B, and use tie only when
you genuinely have no meaningful preference.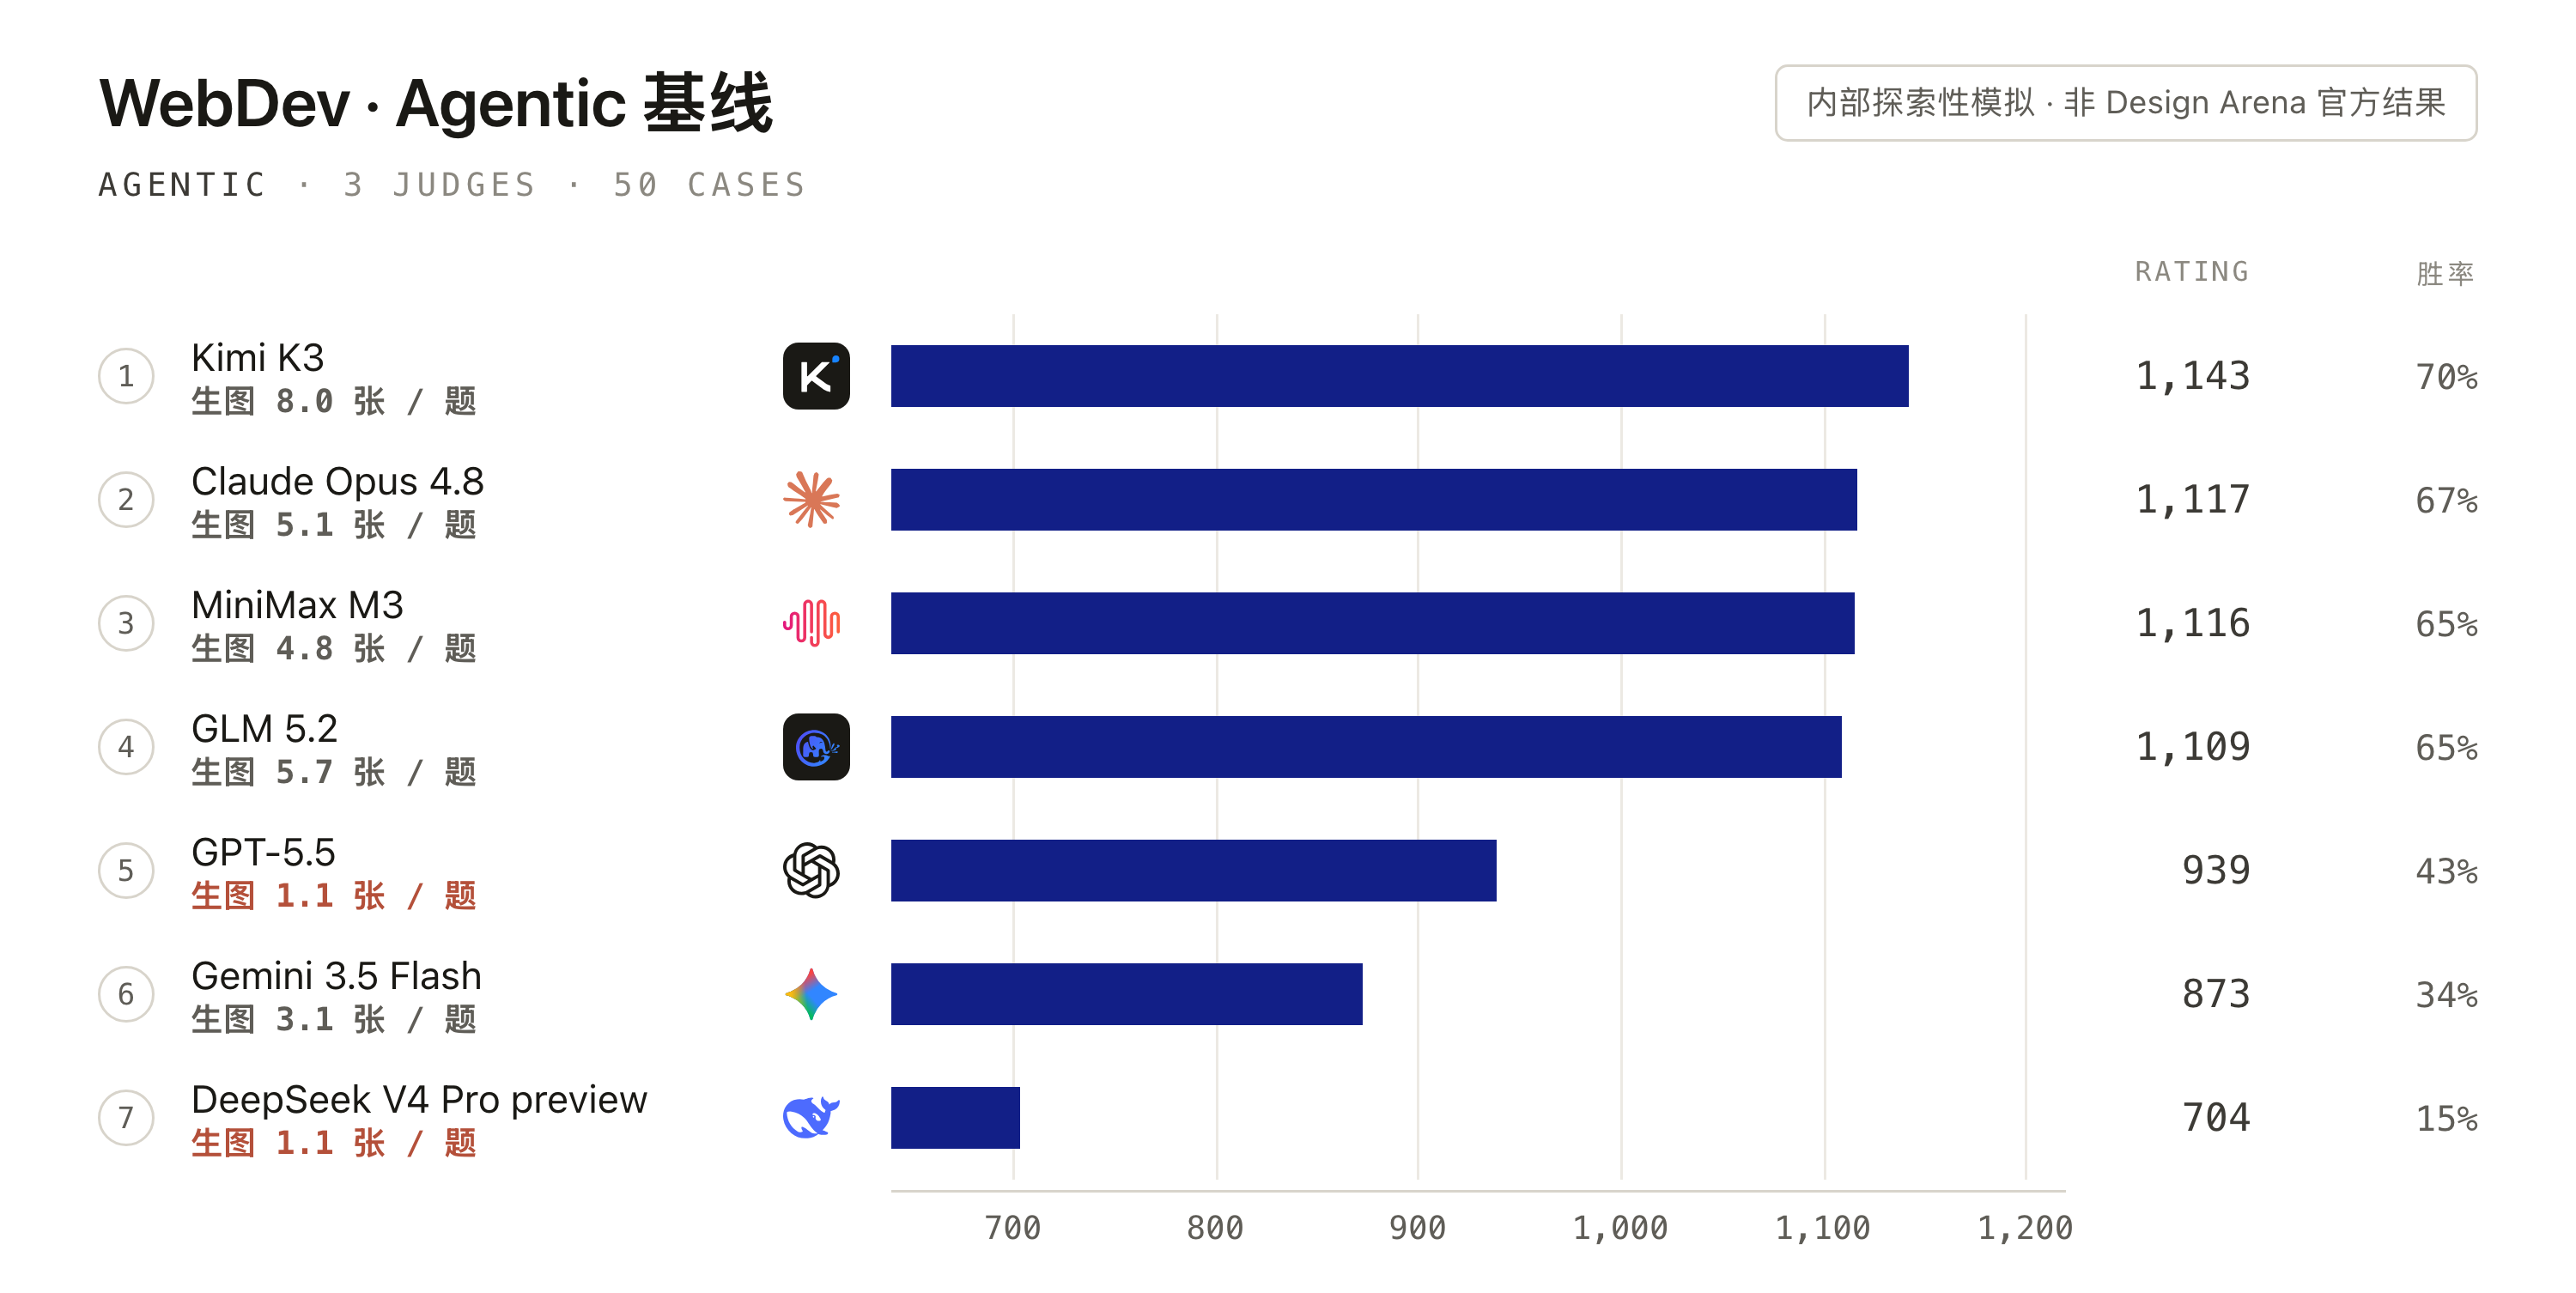
在这组模拟中,不同模型使用生图工具的频率有明显差异。素材调用较多的配置,在部分比较中也获得了更高的偏好分数。这种共同变化不能单独证明“调用更多图片就一定更好”:生成质量、任务类型和评审偏好都可能影响结果。它提示我们,除了是否提供工具,也值得关注 Agent 何时、为何使用工具。
但我们也很快发现:只是把工具挂上去,并不代表模型真的会用。模型往往仍会沿着过去的习惯继续工作——先把结构写完,再用渐变、阴影和色块填满版面。它很少主动停下来想:“这里其实应该有一张图。”
所以,我们在设计阶段增加了一步:先生成一份 design.md。Agent 在规划网页的功能、内容与布局时,也要分析哪些区域需要主视觉、背景、插画或纹理,以及这些素材如何与文字和信息层级配合。对于动态页面,设计稿还可以明确内容入场、滚动揭示、悬停反馈与状态切换,让动效和交互服务于整体表达。等设计方向明确之后,再进入代码与素材的生成阶段。
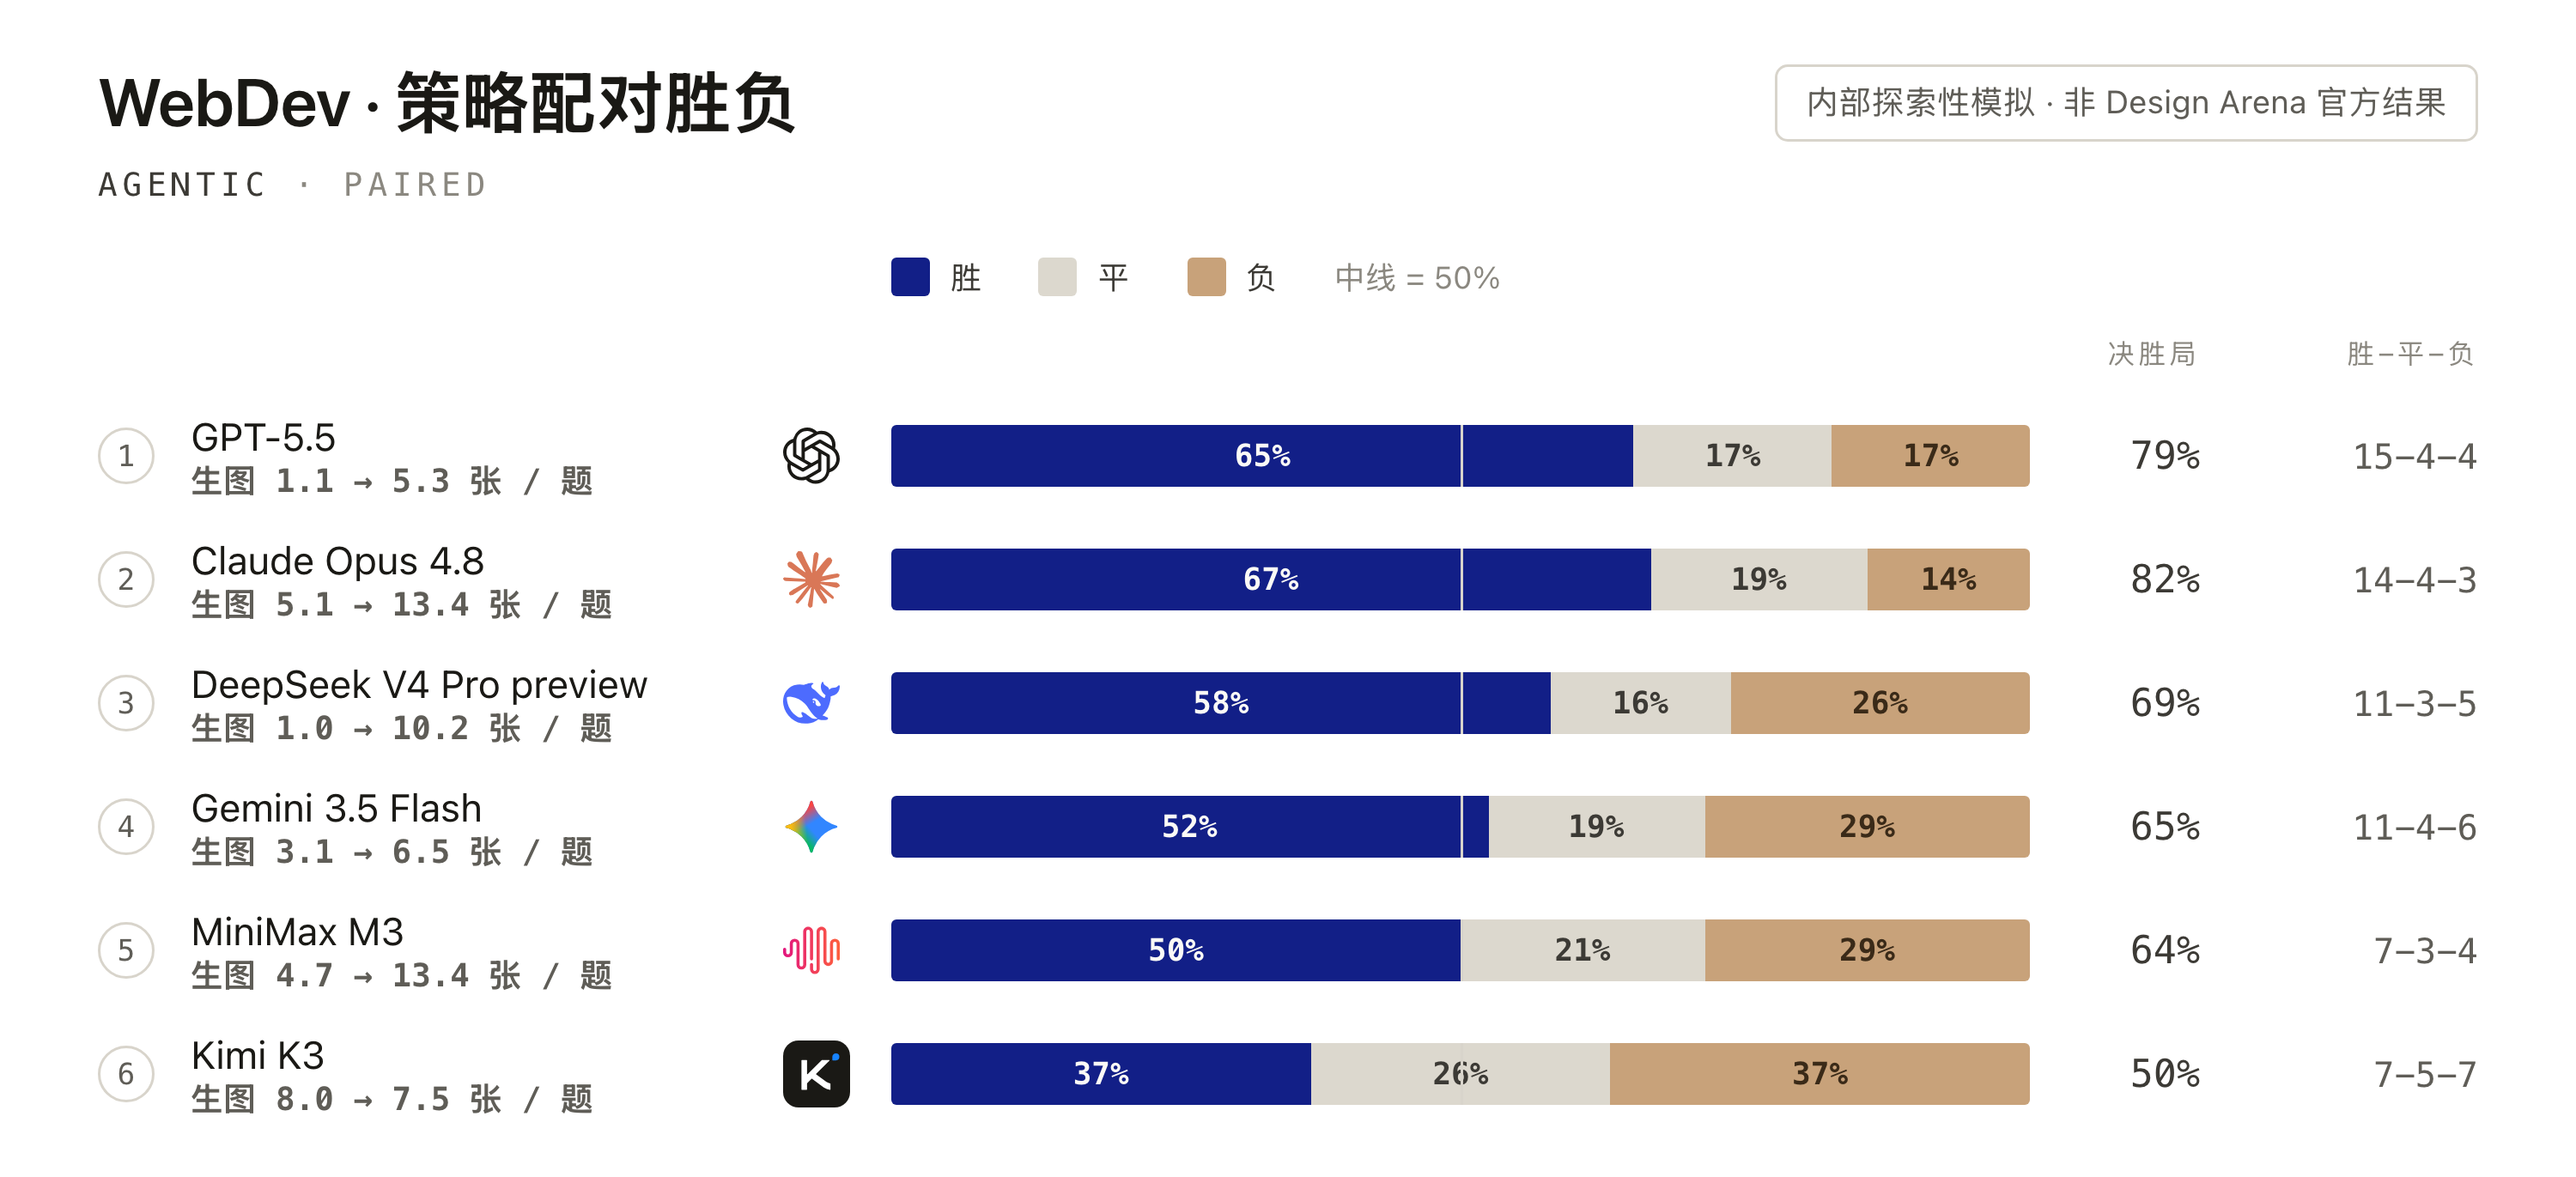
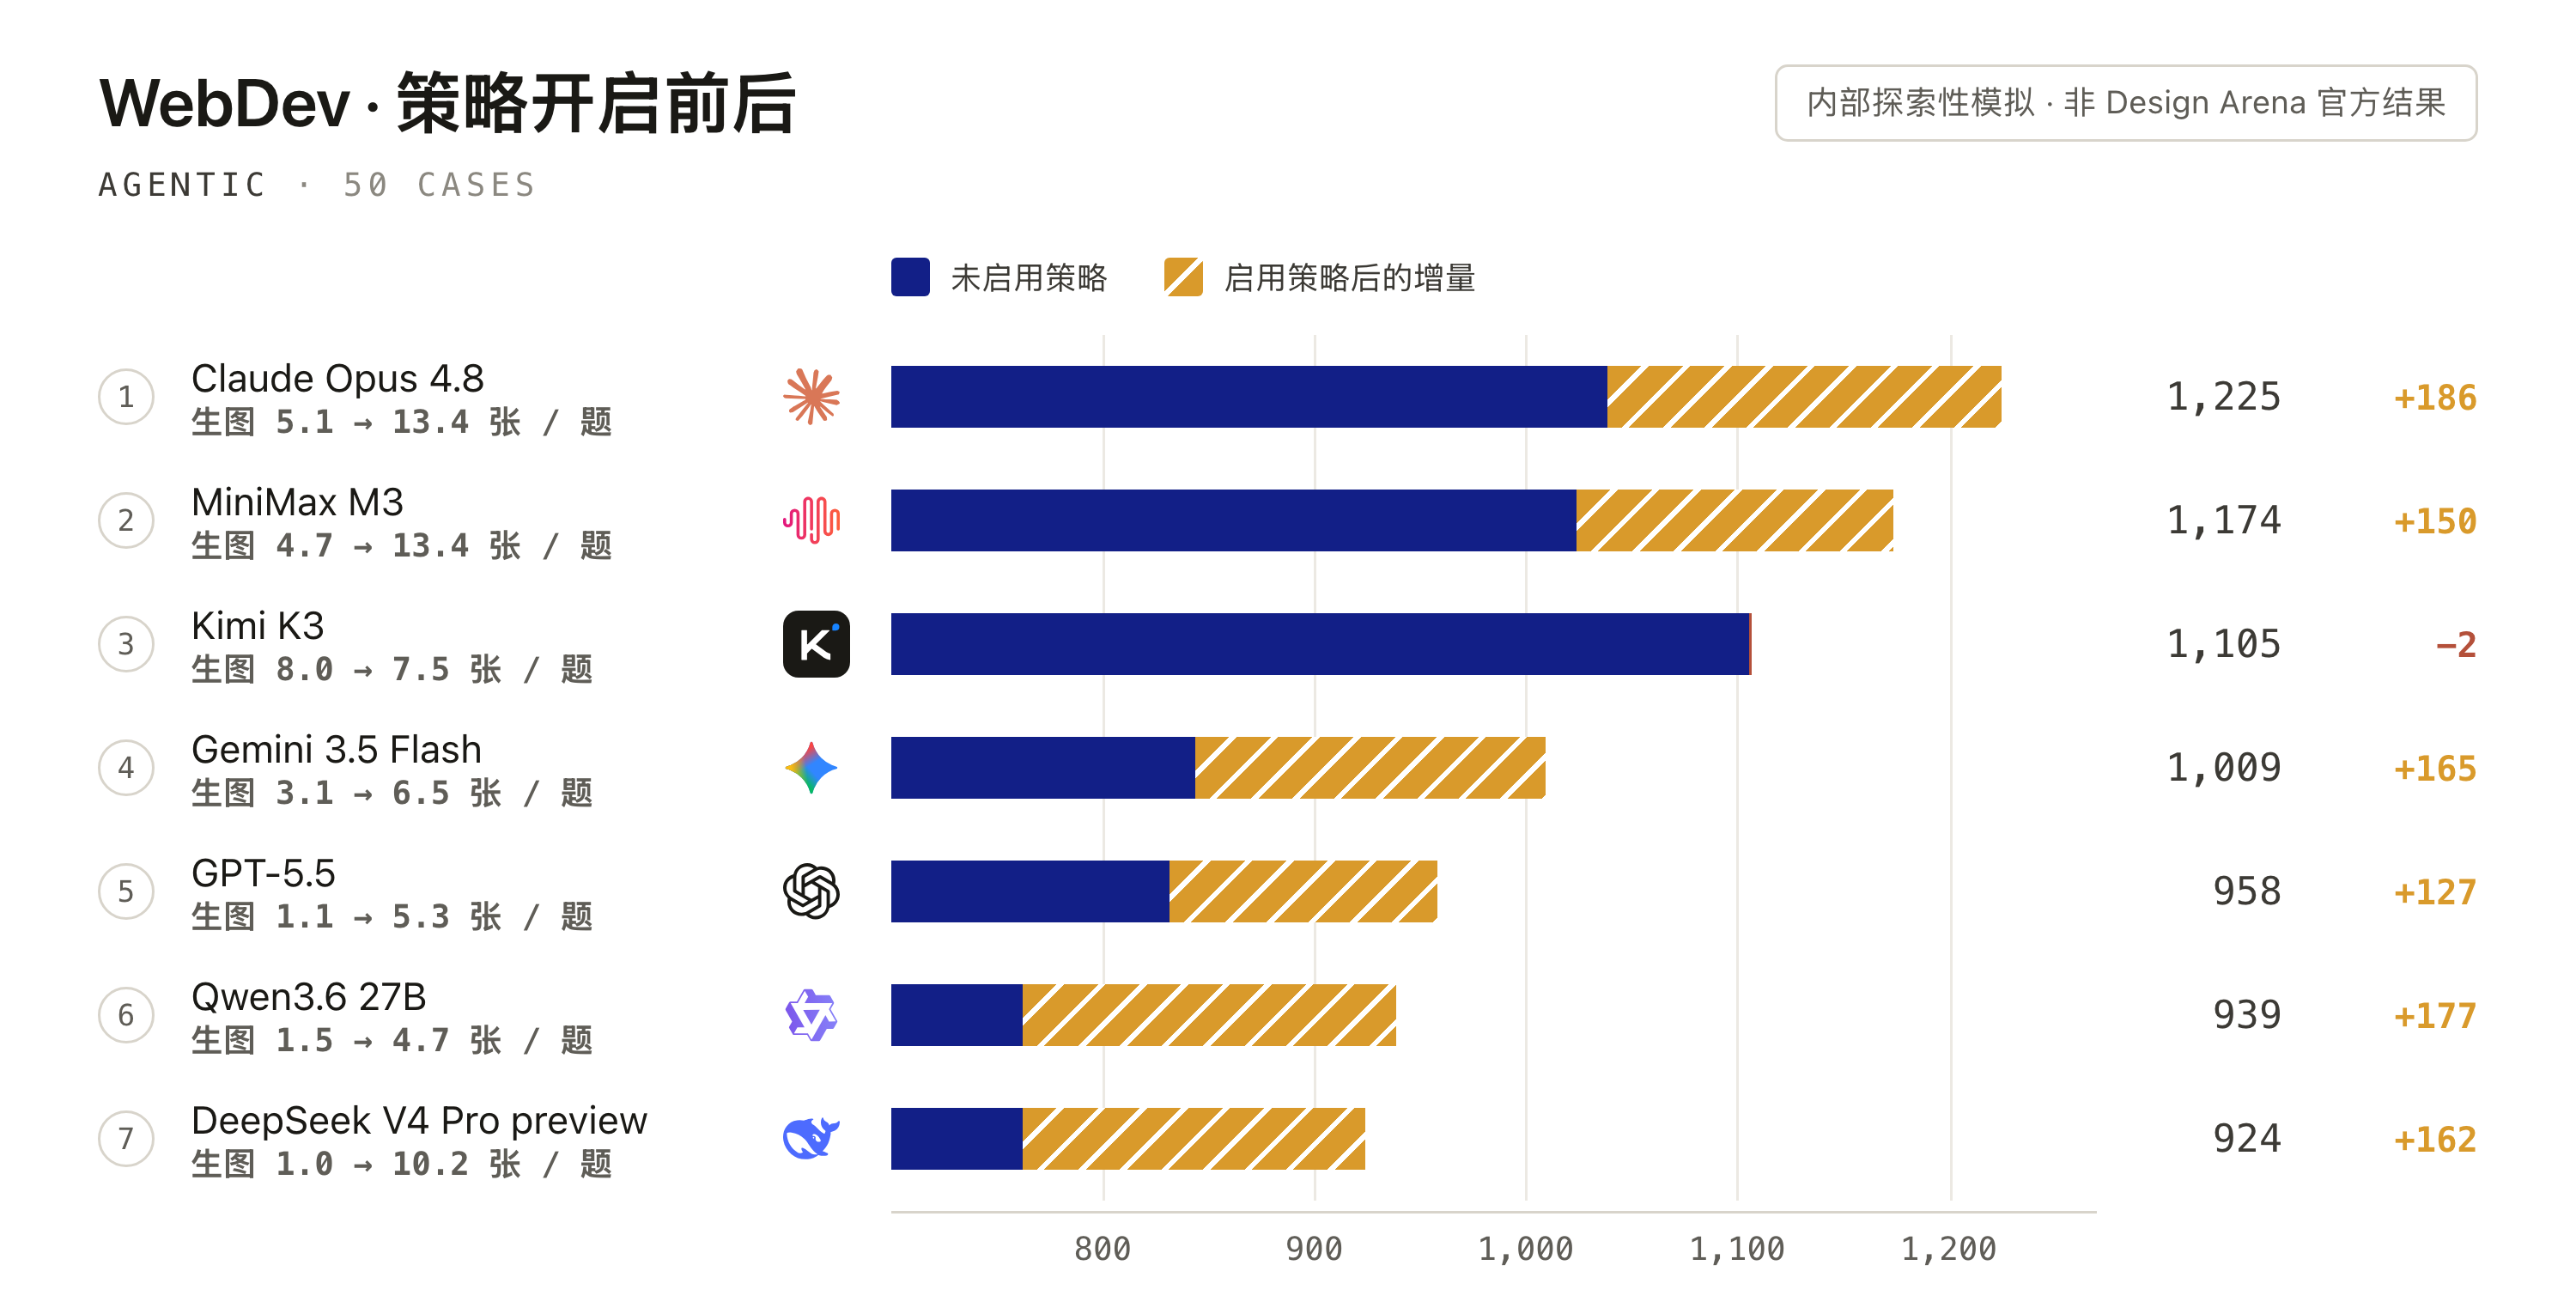
这是一个看起来很小的变化,但它实际上改变了 Agent 的创作顺序:先想清楚画面需要什么,再决定用什么方式把它实现出来。在我们观察的案例中,加上这一步后,一些产物的完成度有所改善。最主要的是,Agent开始更愿意调用图像生成模型了。从下方的结果来看,此前对于生图工具并不感冒的GPT-5.5,Deepseek V4 Pro Preview等模型,在本次模拟的相同 prompt 条件下获得了更高的偏好胜率;这一观察仍需更完整的评估验证。
从 design.md 到设计行为的蒸馏
前面的观察给了我们一个进一步的问题:能否把 design.md 中的设计决策,沉淀为模型生成页面时的默认行为?我们尝试以设计稿为起点做 context distillation,把这条路径组织成四步:
先写设计稿:把页面需求落到
design.md。 从页面内容和使用场景出发,明确主视觉、信息主次、阅读顺序、字体层级、留白与区域比例,形成后续代码生成可以遵循的具体设计规划。联合规划素材与动效:让页面有自己的表达。 在设计稿中写清哪些位置需要摄影、插画或纹理,以及素材与配色、文字和布局如何配合;再按页面需要规划入场顺序、滚动揭示、悬停反馈和状态切换,让视觉素材与动态体验共同引导注意力。
按设计稿生成,再筛选页面。 用
design.md和素材建议引导 Qwen-3.6 27B 生成完整页面,检查结果是否回应原始需求、图片地址是否有效,并对不合格样本过滤或改写。保留的训练目标,是设计意图已经落实到 HTML、CSS 和 JavaScript 中的页面实现。把设计决策蒸馏进默认生成行为。 训练时,以原始用户请求为输入,以筛选后的页面代码为目标;样本生成时使用的
design.md不随训练输入提供。我们希望模型逐步学会在普通请求下自行组织版式、选择素材、安排交互,让“素材放在哪里、信息如何展开、交互怎样响应”成为生成过程中的自然选择。
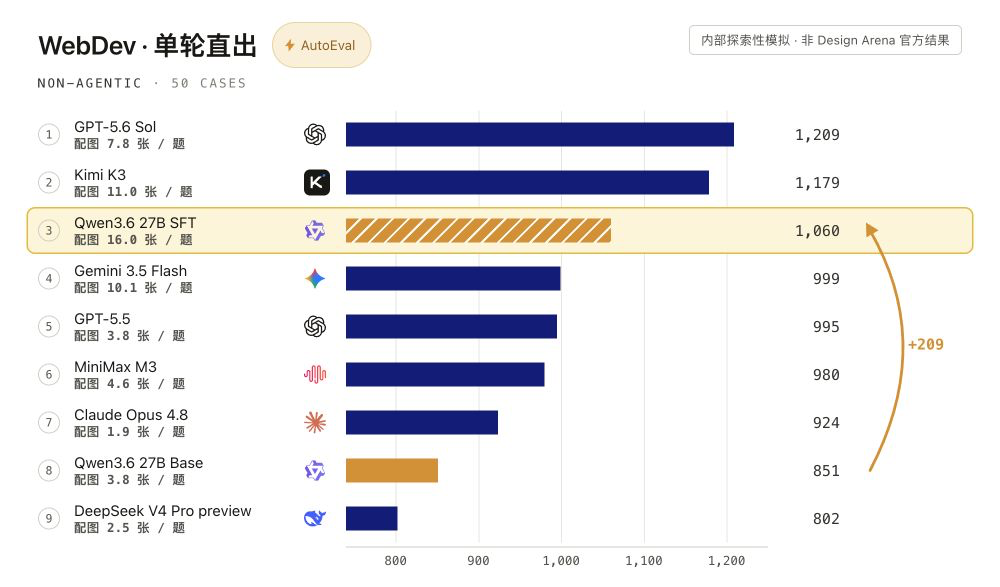
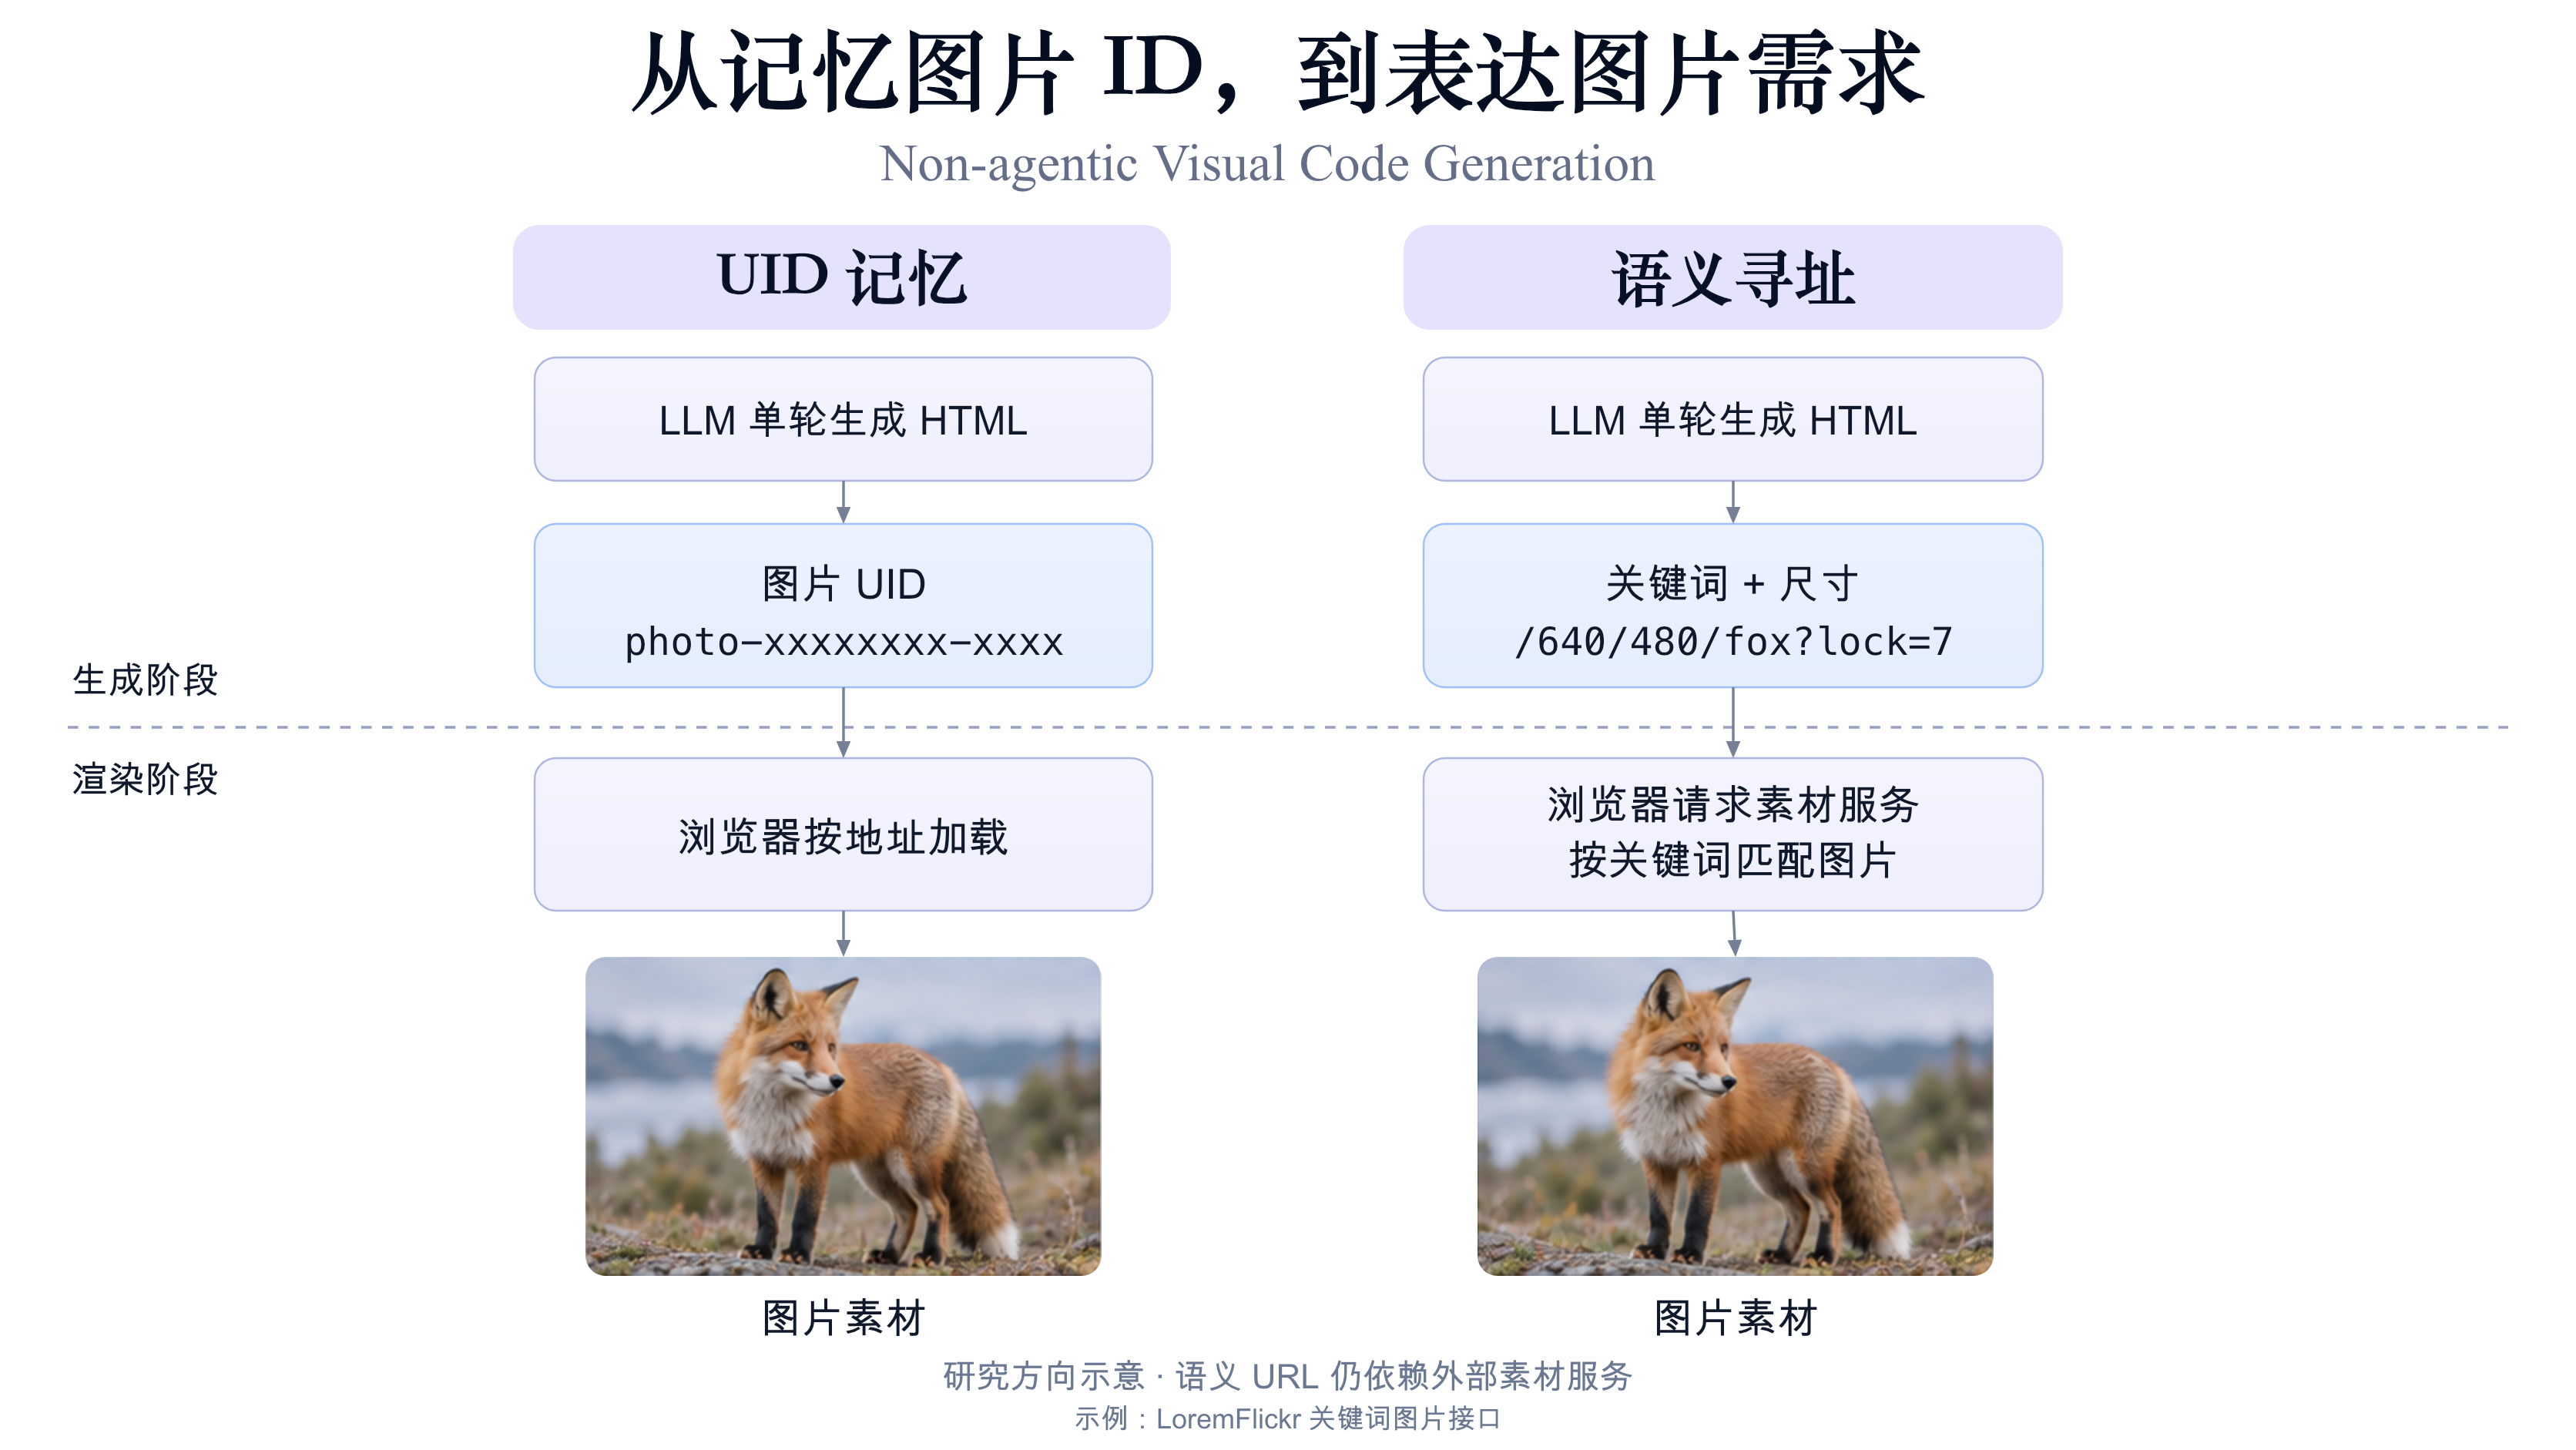
在 Non-Agentic 设置中,模型单轮输出 HTML、CSS 和 JavaScript,页面可以包含动效与交互,但模型在生成过程中不调用搜索或生图工具。图片则可以通过写入外部 URL,由浏览器在加载页面时获取。在我们观察的样本中,一些模型会引用形如 photo-xxxxxxx-xxxxxxx 的 Unsplash ID;相关的图片 ID 使用现象也受到过讨论。加入设计规划和素材建议后,我们观察到包括 Qwen-3.6 27B 在内的一些模型更倾向于使用这些图片资源。
种子 prompt 来自 SamuelBang/AesCode-358K:我们从约 100K 条网页相关数据中,参考 Design Arena 的 What people are building with AI 类别进行抽样与去重,构建了 20K 个 prompt 样本。图片 ID 是这次探索的切入点;更希望模型学到的,是根据页面内容选择与组织素材的习惯。
我们还对生成样本中的图片 UID 进行有效性检测与改写。这组探索性样本记录的页面碎图率由 17% 降至 3%,用于观察素材加载质量的变化。在下方的简化模拟中,context distillation 后的版本也更倾向于使用图片,并获得了更高的模拟偏好分数。
在 Non-agentic 的网页生成中,一个值得探索的方向是语义寻址:模型根据页面内容输出关键词、尺寸等图片需求,由外部素材服务在渲染时匹配图片。例如 LoremFlickr 支持根据 URL 中的关键词和尺寸自动匹配并返回图片,https://loremflickr.com/640/480/fox?lock=7 就会请求一张 640×480、与“狐狸”关键词相关的图片。模型只需要把这个地址写入 HTML,浏览器加载页面时,LoremFlickr 就会返回图像并显示在对应位置。模型仍然是单轮生成 HTML,而训练可以更多关注如何选择与内容、风格和布局相适配的素材,减少对无规则图片 UID 的记忆依赖。
Generation as visual imagination
在 Coding Agent 统治所有任务的今天,似乎多模态内容生成工具也可以很好地嵌入到视觉内容生成当中,让 LLM 更快迈向生产力工具的生成。
多模态工具的加入,确实极大地提升了 Coding Agent 生成 Web-Dev 内容时的视觉丰富度。不过,我们也发现了另一个问题:现有的代码模型仍然非常缺乏对整体画面的把控。
它们精通语法、DOM 树和 Flexbox,却没有稳定的二维空间感和视觉直觉。直接让模型编写前端代码,产物很容易变成高度模板化的“大标题、卡片、圆角阴影”三件套。特别是在 Poster 这类更依赖专业设计的任务中,模型知道代码应该怎么写,却不知道画面应该怎么长才好看。
纵观当前的视觉生成领域,现有的研究主要沿着两条正交的路径展开,但各自都存在“偏科”现象。一方面是偏向“左脑”的纯代码生成——现有的 Coding Agent 就像是一个只有左脑的系统,精通逻辑与结构,但由于代码本质上是一维的符号序列,模型极度缺乏二维空间感与美学直觉。另一方面是偏向“右脑”的视觉内容生成(如扩散模型),它压缩了人类数百年的美术先验,能够瞬间生成具备顶级构图、光影与质感的画面;但它存在致命的“结构死穴”——缺乏严谨的逻辑,生成的像素图(Raster Image)在文字准确性、多层排版、数据图表和后期可编辑性上天然不可靠,无法作为真实的工程交付物。
受 World Action Model (WAM) 策略的启发,我们将图像生成模型前置为 Coding Agent 的“视觉世界模拟器”,而将 LLM 作为后续 Visual Code 的动作决策者。具体而言,在编写代码前,Agent 会先调用图像模型生成一张概念图,以此确立构图、光影和色彩氛围等美学先验,实现“先想象,后行动”。
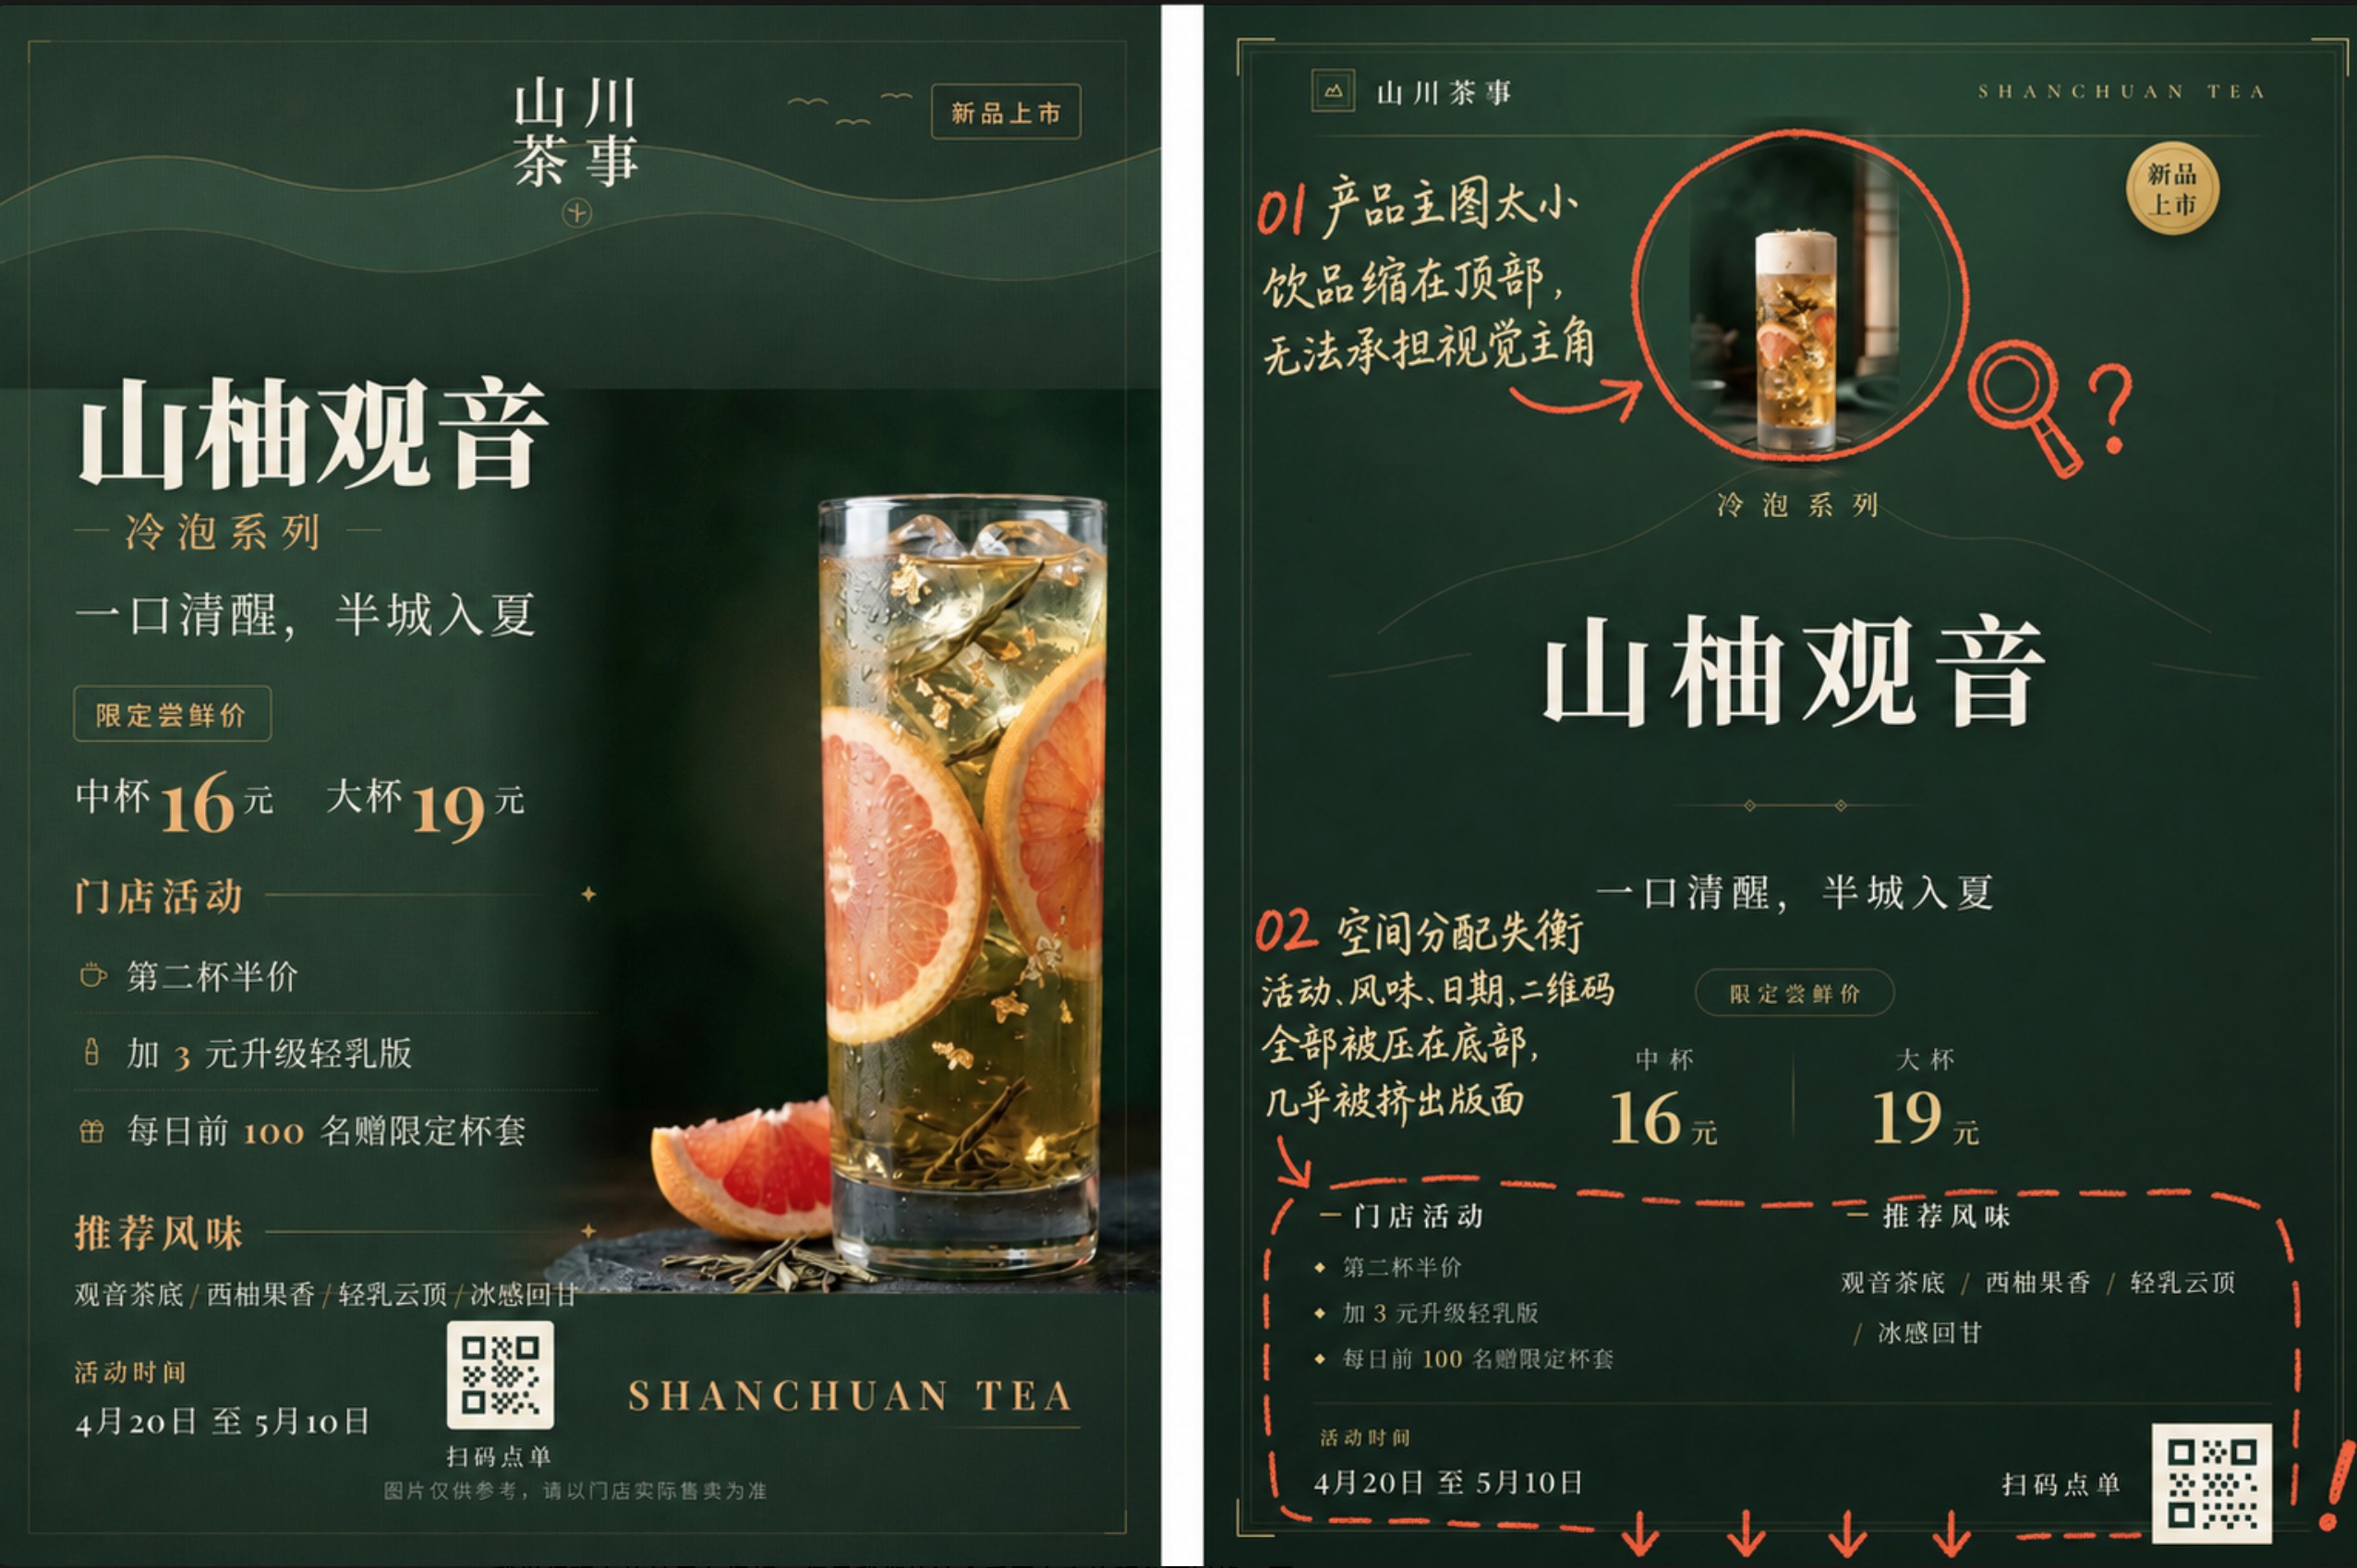
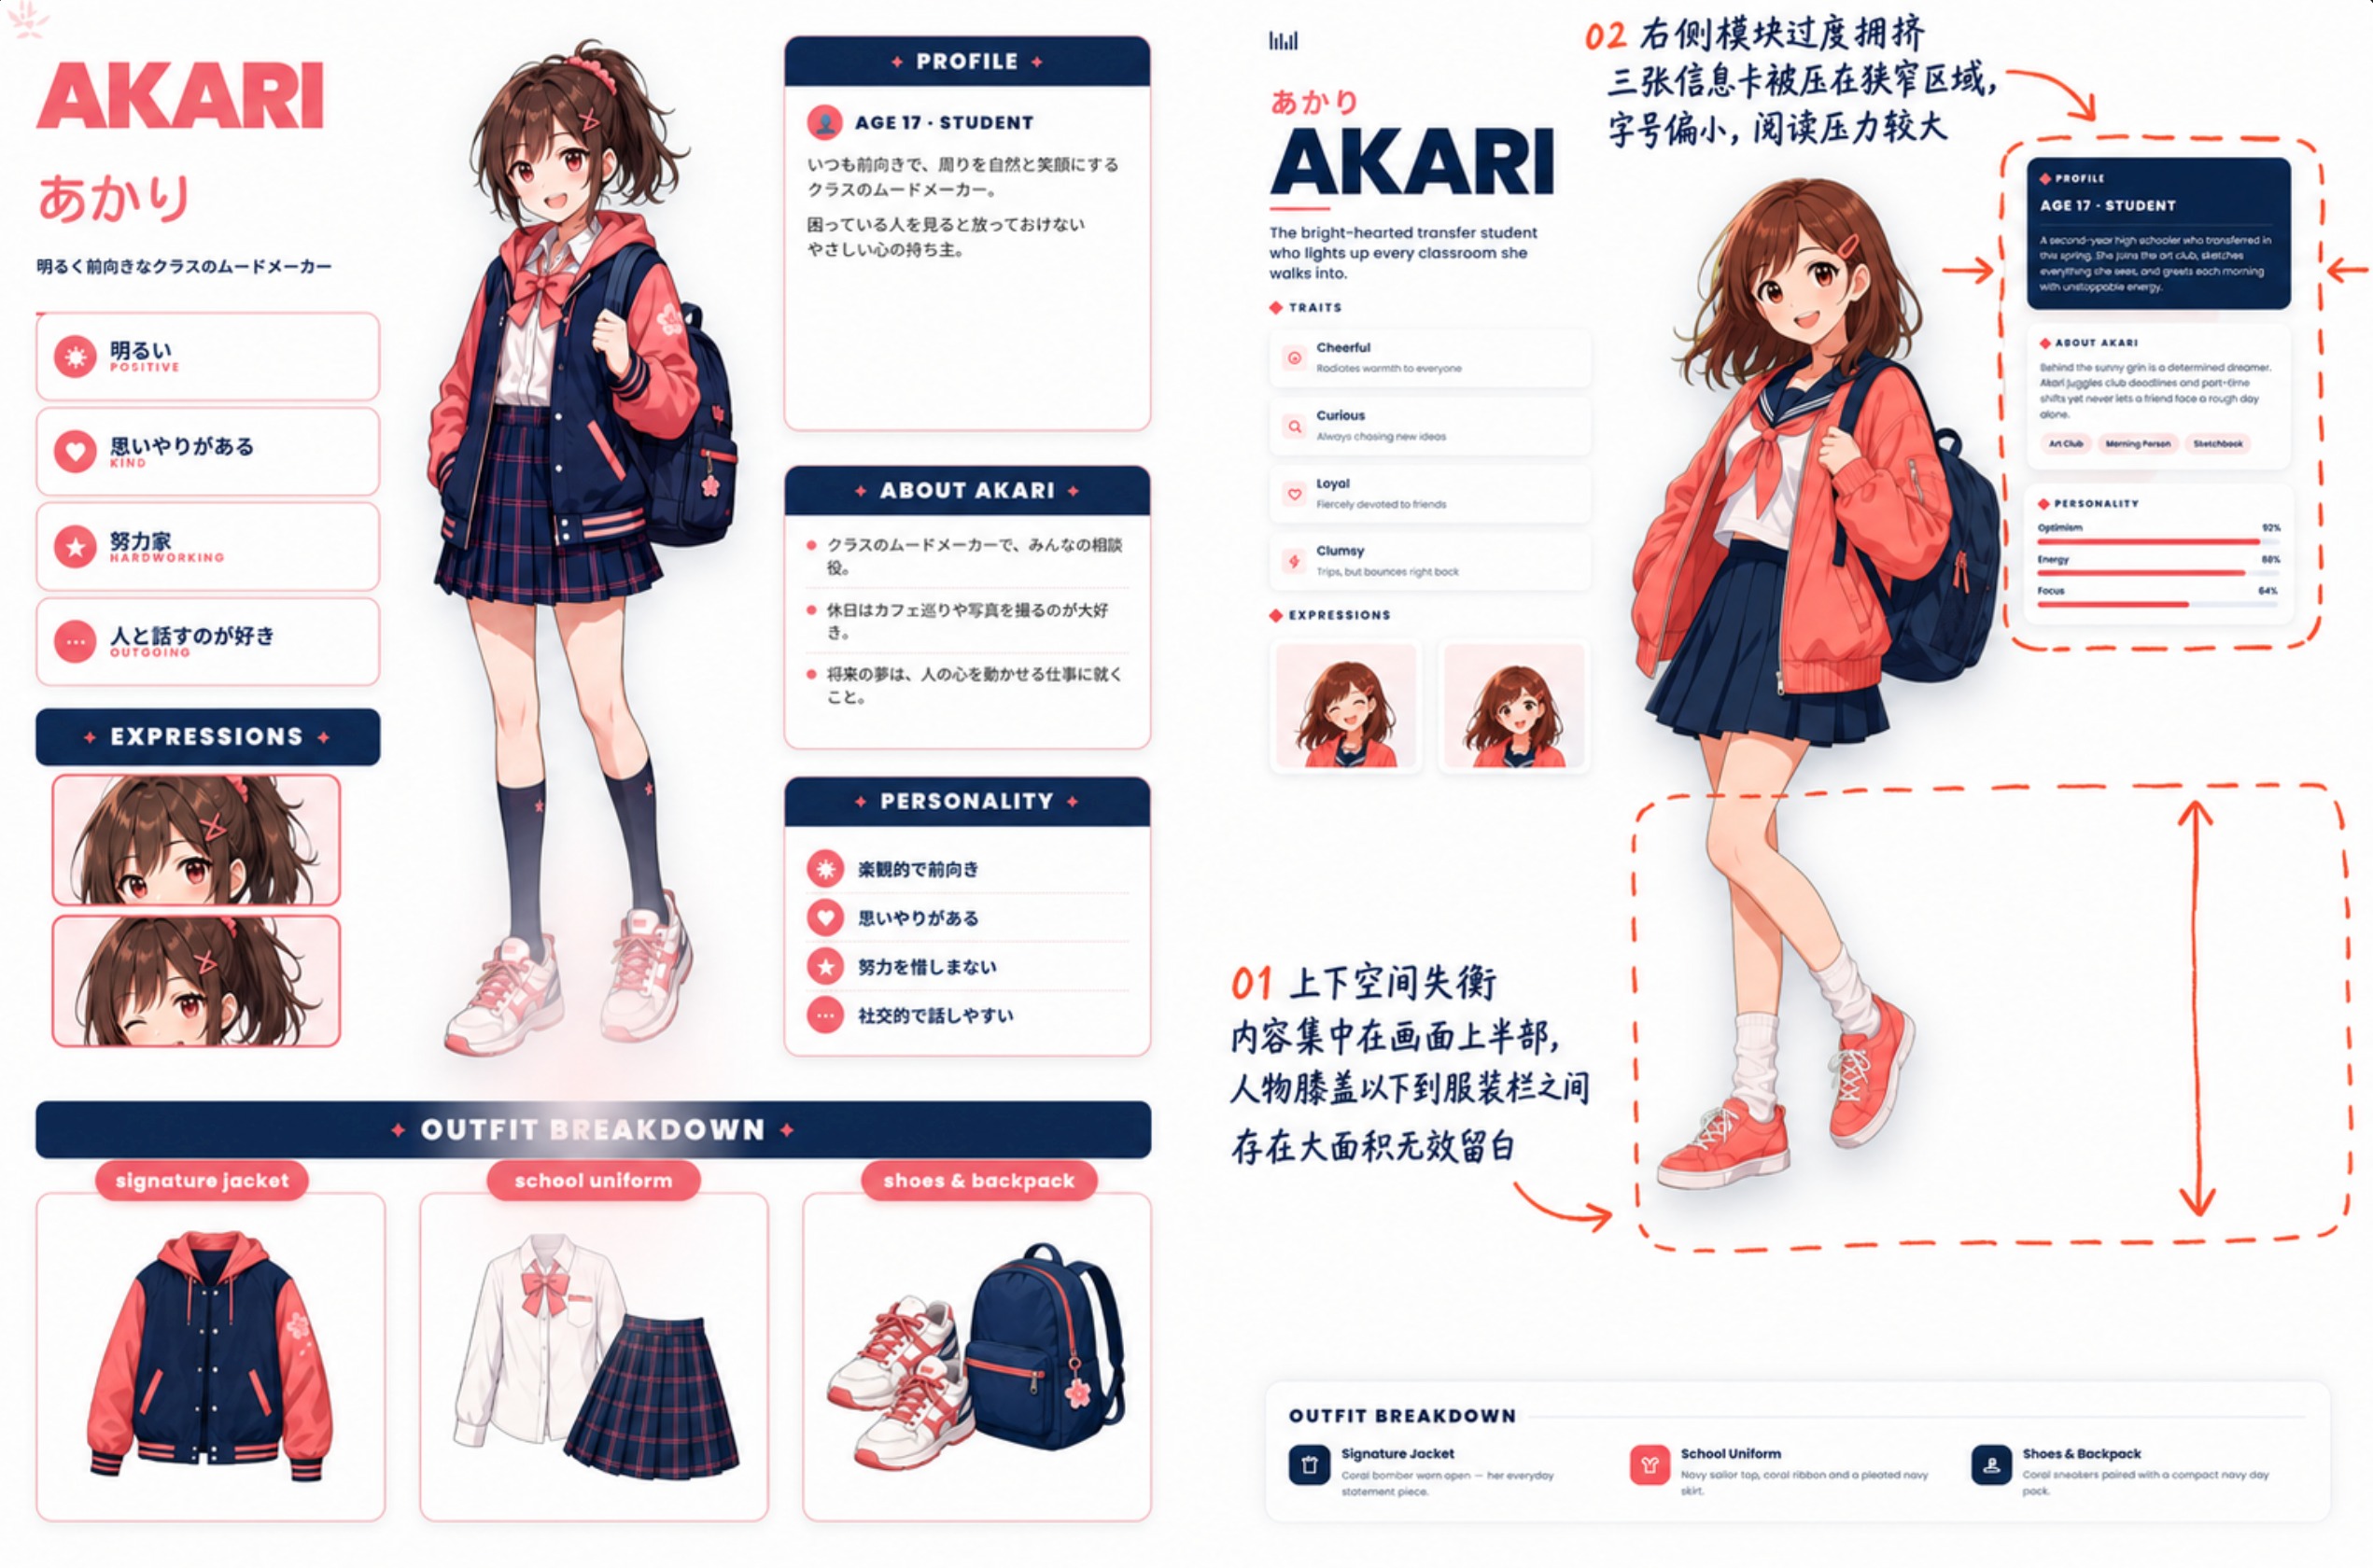
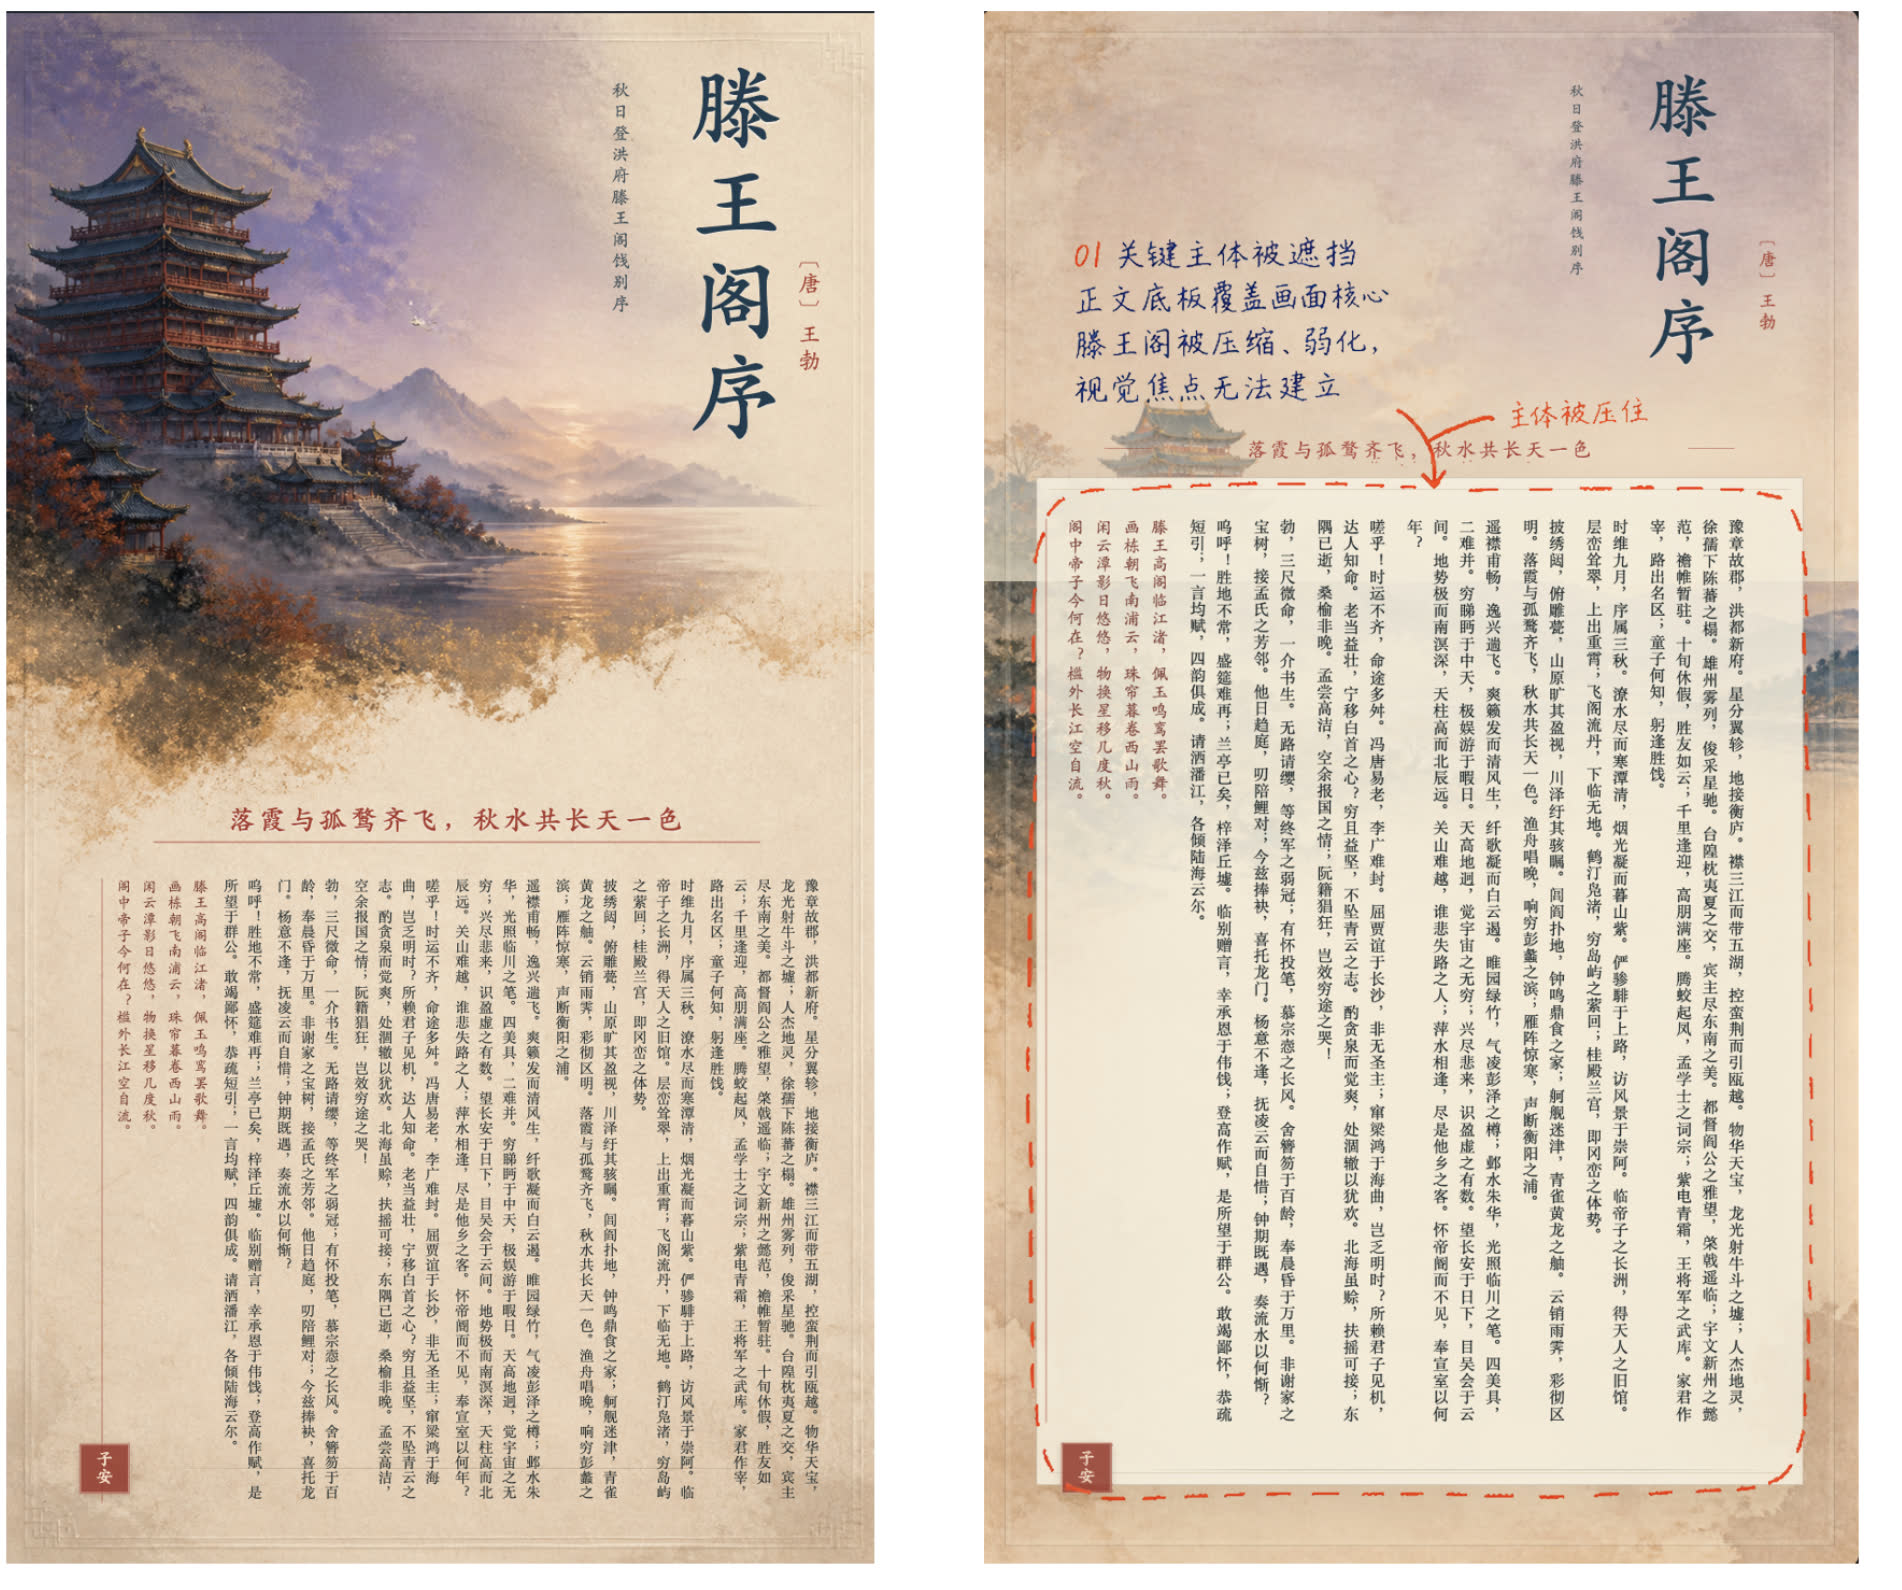
“美学”是一种极难用文字量化、却极易被图像具象化的先验知识。让 Agent 先“看见”一个可能的设计方向,再去写真实内容和可编辑结构,比让它闭着眼睛盲写要可靠得多。
在下方这组探索性模拟中,“有视觉参考”的配置获得了较高的相对分数;海报两两比较记录的偏好比例为 63% vs 37%。这为“先想象,后行动”的设计方式提供了一个值得继续探索的方向。
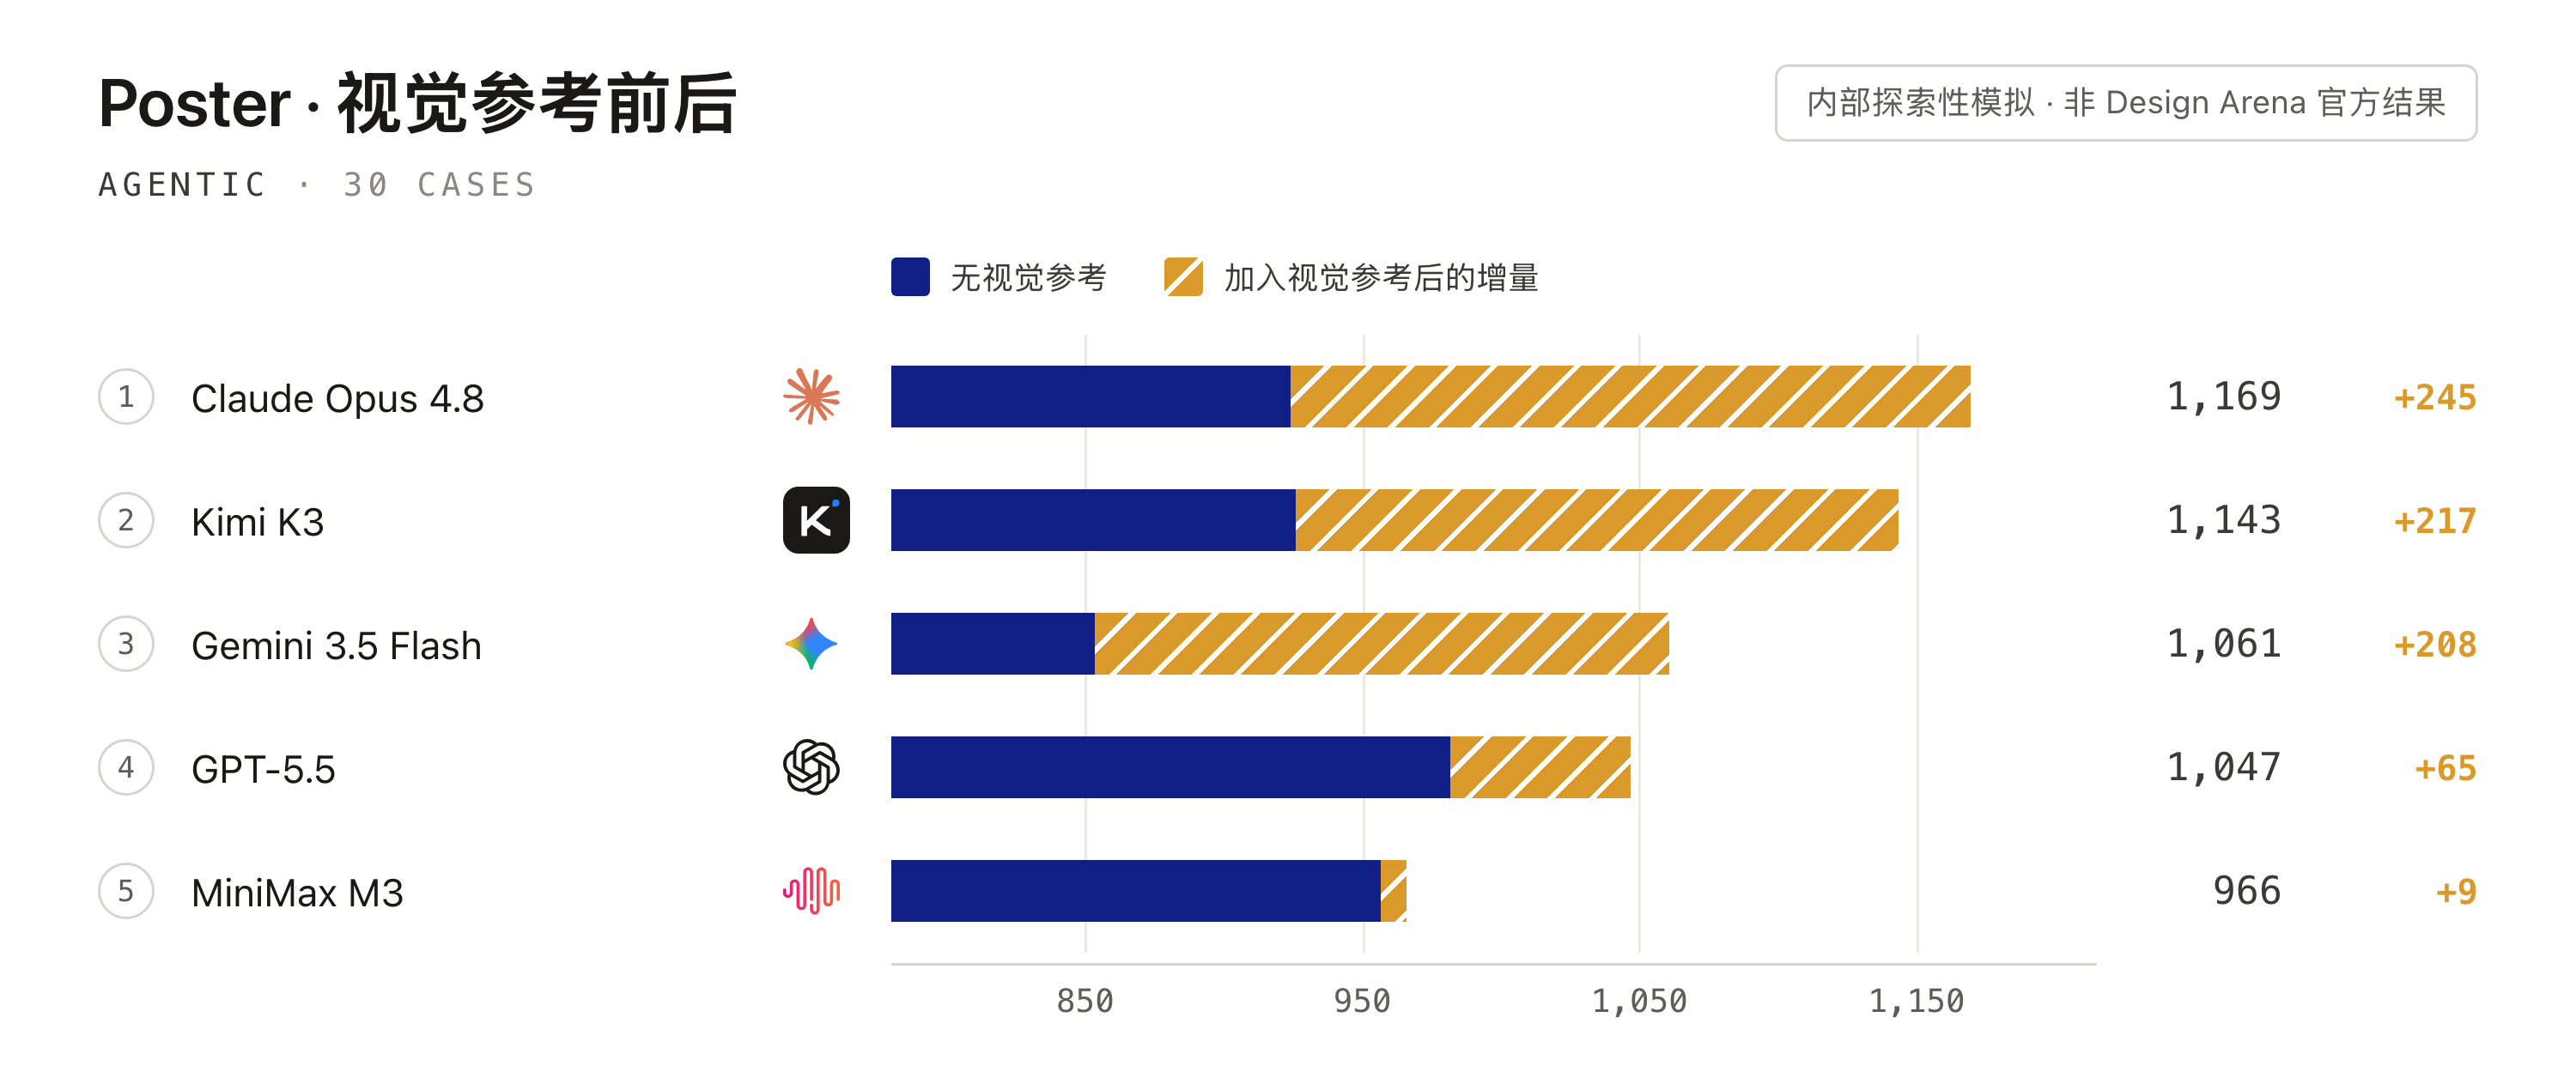
这里还有一个很有意思的反差。过去,多模态领域在探索“生成以辅助理解”(Generation for Understanding)时发现,在严谨的数理逻辑任务中,像素生成带来的噪声往往会产生干扰;但在 Visual Code Generation 中,图像生成反而可能对代码的结构理解与布局决策起到反哺作用。换句话说,图像在这里不只是一种最终素材,也可能成为模型思考设计的中间过程。
Visual Code 作为内容创作的新载体
目前,基于GPT-Image-2、Seedream 5 pro等模型进行创意设计和内容生成,已经成为很多创作者的日常工作流。但我们觉得,Visual Code Generation 也有潜力成为一种新的内容创作载体。
回到我们在 GenClaw 里一直强调的一点:Visual Code 改变的可能不只是“页面好不好看”,还有内容创作的产物形态本身。今天,多模态创作的终点大多是一张像素图。图片一旦交付,文字、图层和布局基本也就定型了。而由 Visual Code 生成的 HTML、PPTX 等产物本身是可编辑的:文字准确、图层可控,用户拿到的不是一张只能整体重做的图片,而是一份可以继续修改的稿件。我们把这条路径做成了一个可以直接使用的 Skill——Editable-Design。
下面这组结果会更直观:
和 GPT-Image-2、Seedream 5 这类直接输出像素的方法相比,Editable-Design 产出的视觉内容允许用户自由拖动元素、修改文字和替换图像素材。在海报、信息图这类需要反复微调的任务中,这一点尤其重要。如果某块图像素材需要更换,也可以只调用一次图像模型做局部替换,而不必把整张作品推翻重来。
最后说说怎么用。GenClaw-Next 本身是一套 model-agnostic、framework-agnostic 的 Agent Harness——不绑定特定的 LLM 供应商,也不绑定特定框架;Editable-Design 则以 Skill 的形式提供,面向 Codex、Claude Code 这类宿主,方便大家直接上手体验。